

AI-First Development · Guido Mitschke · 17. August 2026
Das unsichtbare Wasserzeichen – und die Frage, ob KI gerade unsere Sprache verändert
Ein KI-Wasserzeichen steht in keiner Datei und ist an keinem Pixel zu sehen – es steckt in der Wortwahl selbst. Wie das technisch funktioniert, und warum es eine viel größere Frage aufwirft: Verändert das auf Dauer unsere Sprache?
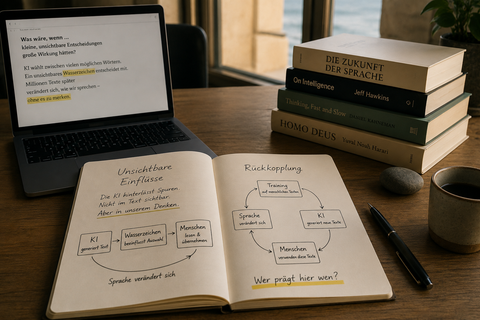
Bild KI-generiert
Auf dieser Seite
- Warum brauchen KI-Texte überhaupt Wasserzeichen?
- Eine KI schreibt anders, als du liest
- Grün oder Rot?
- Aber dann wäre „deutlich" doch ein KI-Wort?
- Ein einzelnes Wort beweist gar nichts
- Das Verfahren rückwärts gedacht
- Warum nicht einfach härter durchgreifen?
- Und wenn ich den Text verändere?
- Die eigentlich spannende Frage
- Ein Gedankenexperiment
- Das Wasserzeichen könnte seinen Urheber überleben
- Entstehen KI-Dialekte?
- Das Problem gibt es auch ohne Watermark
- Ausgerechnet das Wasserzeichen könnte das verstärken
- Das ließe sich sogar messen
- Vielleicht die größere Geschichte
Wenn ich ein Foto mit einem Wasserzeichen versehe, ist die Sache einfach. Irgendwo steht mein Name, mein Logo, eine kaum sichtbare Markierung. Du kannst sie sehen. Oder zumindest technisch aus der Datei auslesen.
Bei Text geht das nicht.
Ein KI-Wasserzeichen kann aus einem völlig normalen Satz bestehen:
Das Ergebnis zeigt eine deutliche Veränderung.
Kein verstecktes Zeichen. Kein unsichtbares „Dieser Text wurde von einer KI geschrieben". Keine Datei im Hintergrund.
Das Wasserzeichen steckt in den Wörtern selbst.
Und genau das macht die Sache interessant. Wenn Maschinen ihre Texte absichtlich anders formulieren müssen, damit man sie später erkennen kann – was macht das mit unserer Sprache, wenn wir diese Texte jeden Tag lesen?
Warum brauchen KI-Texte überhaupt Wasserzeichen?
Seit dem 2. August 2026 gelten die Transparenzvorgaben des EU AI Act. Artikel 50 Absatz 2 verlangt von Anbietern von KI-Systemen, die synthetische Audio-, Bild-, Video- oder Textinhalte erzeugen, dass die Ausgaben in einem maschinenlesbaren Format gekennzeichnet und als künstlich erzeugt oder manipuliert erkennbar sind – soweit technisch machbar. Die Lösung muss wirksam, interoperabel, robust und zuverlässig sein. Ausgenommen sind unter anderem KI-Systeme mit reiner Assistenzfunktion bei der Standardbearbeitung, die die Eingabedaten oder deren Semantik nicht wesentlich verändern. Das heißt: Nicht jeder Text muss ein statistisches Wasserzeichen tragen, und die Pflicht trifft die Anbieter der Systeme, nicht jeden, der einen Text damit schreibt. Für Betreiber gelten eigene Offenlegungspflichten, etwa bei Deepfakes und bei KI-Texten, die die Öffentlichkeit über Themen von öffentlichem Interesse informieren sollen. (AI Act Service Desk)
Bei einem Bild ist das vergleichsweise einfach: Informationen in die Datei schreiben, Signale in den Bilddaten unterbringen.
Aber was machst du mit diesem Satz?
Morgen wird es in Hamburg vermutlich regnen.
Text ist Text. Du kannst ihn markieren, kopieren, in eine E-Mail einsetzen, ausdrucken, wieder abtippen, per WhatsApp verschicken. Metadaten sind dann schnell weg.
Also kam jemand auf eine ziemlich clevere Idee: das Wasserzeichen nicht neben den Text packen, sondern in den Entstehungsprozess des Textes selbst.
Eine KI schreibt anders, als du liest
Wenn du liest:
Das Ergebnis ist deutlich.
wirkt das vollkommen selbstverständlich.
Für ein Sprachmodell sah die Lage einen Moment vorher ungefähr so aus:
Das Ergebnis ist …
Und jetzt muss es sich entscheiden. Vielleicht berechnet das Modell:
| mögliches nächstes Wort | Wahrscheinlichkeit |
|---|---|
| deutlich | 18 % |
| klar | 16 % |
| eindeutig | 13 % |
| bemerkenswert | 7 % |
| erheblich | 6 % |
| relevant | 4 % |
Die Zahlen sind nur ein Beispiel, aber das Prinzip stimmt: Es gibt nicht „das richtige nächste Wort". Es gibt viele mögliche nächste Tokens mit unterschiedlichen Wahrscheinlichkeiten. Und genau hier lässt sich ein Wasserzeichen einbauen.
Grün oder Rot?
Stell dir vor, das Watermark-System teilt die möglichen Wörter heimlich in zwei Gruppen.
- 🟢 Grün: deutlich, eindeutig, relevant
- 🔴 Rot: klar, bemerkenswert, erheblich
Diese Zuordnung siehst du nicht. Das Modell bekommt nur eine kleine Zusatzanweisung: Wenn mehrere Wörter passen, bevorzuge ein wenig die grünen.
Aus „Das Ergebnis ist klar." wird also vielleicht „Das Ergebnis ist deutlich."
Beides korrekt. Beides klingt normal. Beides bedeutet ungefähr dasselbe. Aber das zweite Wort trägt zu einem statistischen Muster bei.
Genau das steckt hinter einer wichtigen Klasse wissenschaftlich untersuchter LLM-Watermarks: Vor jedem Token wird eine pseudorandomisierte „Green List" bestimmt, deren Tokens werden bei der Auswahl leicht bevorzugt. (Proceedings of Machine Learning Research)
Aber dann wäre „deutlich" doch ein KI-Wort?
Nein. Und das ist der eigentliche Trick: „Deutlich" ist nicht grundsätzlich grün. Beim nächsten Satz kann es rot sein.
Welche Wörter grün sind, wird immer wieder neu berechnet – vereinfacht gesagt aus geheimem Schlüssel plus bisherigem Text. Nach „Das Ergebnis ist …" könnte „deutlich" grün sein. Nach „Der Unterschied zwischen beiden Gruppen ist …" könnte es rot sein. Nach „Die Bundesregierung erklärte …" wird wieder eine ganz andere Liste erzeugt.
Du kannst also keine Liste mit „KI-Wörtern" anlegen. Das Wasserzeichen entsteht erst durch viele Entscheidungen hintereinander.
Ein einzelnes Wort beweist gar nichts
Nimm einen menschlichen Text mit 100 Entscheidungen. Wenn Grün und Rot etwa gleich verteilt sind, landest du zufällig bei sowas wie 50 zu 50. Vielleicht 47 zu 53, vielleicht 54 zu 46 – Zufall.
Erzeugt eine KI mit aktiviertem Watermark denselben Umfang und bevorzugt systematisch Grün, kommst du auf 68 zu 32. Das fällt auf. Bei einem längeren Text vielleicht 271 zu 129.
Jetzt kann ein statistischer Test fragen: Wie wahrscheinlich wäre dieses Ergebnis durch Zufall entstanden? Genau darauf beruht das klassische Green-List-Verfahren – der Detektor rekonstruiert für jede Position die Grünliste und zählt die Treffer, daraus lässt sich zum Beispiel ein Z-Score berechnen. (DOI)
Das Verfahren rückwärts gedacht
Der Prüfer bekommt nur den fertigen Text:
Das Ergebnis zeigt eine deutliche Veränderung. Besonders relevant ist dabei die Entwicklung der vergangenen Monate. Darüber hinaus lassen sich eindeutige Unterschiede zwischen den Gruppen feststellen.
Er kennt aber den Schlüssel bzw. das Verfahren. Also rekonstruiert er beim ersten Token: Welche Wörter wären hier grün gewesen? Welches Wort steht tatsächlich da? Treffer oder kein Treffer. Nächstes Token, wieder rekonstruieren. Treffer, kein Treffer, Treffer, Treffer – und so weiter.
Am Ende steht zum Beispiel: erwartet 50 % Grün, gefunden 68 % Grün. Alle Zahlen in diesem Abschnitt sind frei gewählte Rechenbeispiele zur Veranschaulichung, keine Messwerte aus einer Studie.
Daraus wird noch keine Aussage wie „Dieser Text stammt definitiv von einer KI" – sondern erstmal eine statistische: Dieses Muster wäre bei einem unmarkierten Text sehr unwahrscheinlich. Der Unterschied ist wichtig.
Warum nicht einfach härter durchgreifen?
Man könnte sagen: Die KI darf nur noch grüne Wörter benutzen. Dann wäre das Wasserzeichen glasklar erkennbar.
Aber dann würde die KI irgendwann sowas schreiben wie „Das Resultat präsentiert eine substanzielle Modifikation der vorhergehenden Entwicklung" – obwohl jeder normale Mensch einfach „Es hat sich einiges geändert" geschrieben hätte. Das Wasserzeichen würde anfangen, die Sprache sichtbar zu beschädigen.
Deshalb machen sogenannte Soft-Watermarks die grünen Tokens nur wahrscheinlicher, nicht zwingend. Genau dieser Kompromiss zwischen Erkennbarkeit und Textqualität ist ein zentrales Forschungsthema. (Springer)
Und wenn ich den Text verändere?
Jetzt wird's kompliziert. Aus „Das Ergebnis zeigt eine deutliche Veränderung." mache ich „Das Resultat hat sich klar verändert." Ein paar der ursprünglichen Token sind weg. Ich ändere noch einen Satz, dann einen Absatz. Vielleicht übersetze ich ins Englische und zurück. Das Wasserzeichen wird schwächer.
Tokenbasierte Watermarks reagieren empfindlich auf sowas wie Synonym-Tausch. Neuere Verfahren versuchen, das robuster zu machen. (Springer)
Damit steht ein Wasserzeichen vor einem Zielkonflikt: Es soll unsichtbar sein, den Inhalt nicht verändern, den Schreibstil nicht verschlechtern, zuverlässig erkennbar sein, Bearbeitung überstehen – und möglichst keine menschlichen Texte fälschlich markieren. Das geht nicht alles gleichzeitig gut.
Die eigentlich spannende Frage
Was macht das mit uns? Wir lesen diese Texte jeden Tag – E-Mails, Produktbeschreibungen, LinkedIn-Beiträge, Pressemitteilungen, Webseiten, Bewerbungen, Zeitungsartikel, vielleicht Bücher. Wenn ein erheblicher Teil davon von Sprachmodellen stammt, liest du zunehmend Sprache, deren Wortwahl von Maschinen geprägt wurde. Watermarking legt da noch eine Ebene drauf.
Ein Gedankenexperiment
Vor der KI werden vier Formulierungen etwa gleich häufig benutzt: außerdem, zudem, weiterhin, darüber hinaus.
Jetzt bevorzugt ein Watermark-Verfahren unter bestimmten Bedingungen minimal häufiger „zudem" und „darüber hinaus". Nicht immer, nur ein bisschen. Aber das Modell erzeugt Milliarden Sätze, die Menschen lesen.
Ein Mitarbeiter liest jeden Tag „Darüber hinaus sollte berücksichtigt werden …". Irgendwann schreibt er selbst „Darüber hinaus sollte berücksichtigt werden …" – nicht weil er eine KI benutzt, sondern weil ihm die Formulierung inzwischen normal vorkommt. Kollegen lesen den Satz, andere Seiten übernehmen ihn, Suchmaschinen indexieren ihn. Irgendwann landet dieser menschlich geschriebene Text vielleicht wieder in den Trainingsdaten einer künftigen KI.
Dann hast du eine Schleife: KI → Mensch → Internet → Trainingsdaten → KI → Mensch. Das ursprüngliche künstliche Sprachmuster wäre in die natürliche Sprache zurückgeflossen.
Das Wasserzeichen könnte seinen Urheber überleben
Das ist der Teil, der mich am meisten interessiert. Stell dir vor, ein bestimmtes KI-Modell wird 2027 abgeschaltet, sein Watermark-Verfahren nie wieder verwendet. Millionen Menschen haben aber jahrelang Texte dieses Systems gelesen. Ein Teil seiner sprachlichen Vorlieben könnte inzwischen in menschlichen Texten stecken.
Das technische Wasserzeichen wäre dann weg. Seine sprachliche Spur vielleicht nicht. Das wäre dann kein Wasserzeichen mehr – das wäre Sprachentwicklung.
Entstehen KI-Dialekte?
Auch das ist zumindest als Hypothese interessant. Modell A bevorzugt statistisch Muster A, Modell B Muster B, Modell C Muster C. Alle drei produzieren Milliarden Texte. Über Jahre könnten sich statistische Unterschiede herausbilden – nicht so, dass du sagen würdest „Der schreibt eindeutig ChatGPT-Deutsch", aber vielleicht messbar genug, dass Linguisten feststellen: bestimmte Konstruktionen treten seit 2026 deutlich häufiger auf.
Man könnte das maschinelle Soziolekte nennen. Keine Dialekte im klassischen Sinn, sondern statistisch unterschiedliche Varianten derselben Sprache, geprägt durch die verwendeten Modelle.
Das Problem gibt es auch ohne Watermark
Das muss man dazusagen. KI verändert unsere Sprache vermutlich schon heute, völlig unabhängig von Wasserzeichen. Wenn Millionen Menschen täglich Texte eines Sprachmodells lesen und übernehmen, verbreiten sich dessen bevorzugte Formulierungen. Noch relevanter dürfte die Rückkopplung beim Training künftiger Modelle sein.
Eine Studie zu rekursivem Training auf synthetischen Texten fand über mehrere Generationen einen Rückgang lexikalischer, syntaktischer und semantischer Vielfalt – am stärksten bei kreativeren Aufgaben. Untersucht wurden englische Texte, das heißt: für Deutsch ist das damit noch nicht belegt, nur naheliegend. (ACL Anthology)
Trotzdem bleibt die Frage spannend: Was passiert mit einer Sprache, wenn Maschinen zunehmend Texte von Maschinen lesen – und Menschen zunehmend Texte von Maschinen?
Ausgerechnet das Wasserzeichen könnte das verstärken
Ein gutes Watermark soll die Bedeutung eines Textes nicht verändern. Das heißt aber nicht, dass es keinen Einfluss auf Sprache hat. Wenn zwei Formulierungen praktisch gleichwertig sind und das System eine davon systematisch etwas häufiger wählt, bleibt die Bedeutung gleich – aber die Verteilung der Sprache verändert sich trotzdem.
Und genau daraus besteht Sprache: Welche Wörter wir benutzen, welche verschwinden, wie wir einen Satz anfangen, wie lang unsere Sätze sind, welche Redewendungen uns normal vorkommen, welche Synonyme wir bevorzugen, wie unterschiedlich verschiedene Menschen denselben Gedanken formulieren.
Ein einzelnes Watermark verändert kein Deutsch. Milliarden künstlich erzeugter Texte könnten das schon.
Das ließe sich sogar messen
Man könnte große deutsche Textbestände aus verschiedenen Jahren vergleichen, 2018 bis 2026. Zum Beispiel: aber / jedoch / allerdings. Oder: außerdem / zudem / darüber hinaus. Oder ganze Konstruktionen wie „Entscheidend ist dabei …", „Ein weiterer wichtiger Aspekt …", „Zusammenfassend lässt sich sagen …".
Zeitungen gegen Unternehmenswebseiten. Wikipedia gegen Marketingtexte. Bundestagsreden gegen LinkedIn. Bereiche mit vermutlich hoher KI-Nutzung gegen Bereiche, in denen Menschen überwiegend selbst schreiben. Und dann messen, ob die sprachliche Vielfalt abnimmt. Aus einer Vermutung würde eine überprüfbare Frage.
Vielleicht die größere Geschichte
Beim Watermarking diskutieren wir gerade vor allem: Können wir erkennen, ob ein Text von einer KI stammt? Auf Dauer ist das vermutlich die falsche Frage. Die interessantere: Können wir irgendwann überhaupt noch sinnvoll zwischen menschlicher und maschineller Sprache unterscheiden?
Die KI lernt unsere Sprache. Wir lesen ihre Sprache und übernehmen ihre Formulierungen. Sie trainiert wieder auf unseren Texten. Mit jeder Runde wird schwerer zu sagen, wer hier eigentlich wen beeinflusst.
Vielleicht sprechen künftige Linguisten deshalb gar nicht vom „KI-Deutsch". Vielleicht sagen sie einfach: So hat sich Deutsch in den 2020er-Jahren verändert. Und ein kleiner Teil davon geht ausgerechnet auf ein Verfahren zurück, das eigentlich dafür gedacht war, menschliche und maschinelle Texte auseinanderzuhalten.
Weiterlesen: Im zweiten Teil geht es um die viel größere Frage dahinter – was passiert, wenn KI irgendwann keinen für Menschen lesbaren Code mehr braucht, und wer dann festlegen darf, was gilt.
Der Autor zeichnet für Inhalt und Aussage dieses Artikels verantwortlich. Sprachliche Ausformulierung und Hintergrundrecherche wurden nach Vorgaben des Autors mit KI-Unterstützung erstellt.